Python 专区
数据清洗与可视化实践
清洗虚构成绩数据,记录规则并生成可复现的统计图。
展开本篇目录
一、为什么需要数据清洗?
一份表格能打开,不代表可以直接计算。重复记录、空值、文本数字、非法范围和错误日期都会改变结果。本篇用 8 行虚构成绩数据,完整走一遍读取、审计、清洗、汇总和绘图。
目标不是让表格“没有空格和空值”,而是让每一条处理规则有理由、有记录、可复现。先修 Python 基础和简单 pandas 操作;如果尚不熟悉 DataFrame,可先阅读《Python 基础库》。
二、准备数据与环境
下载 raw_scores.csv · 下载完整 clean_scores.py
|
样例数据全部虚构,真实成绩应先获得使用授权并避免公开个人信息。
| 行 | 学号 | 组别 | score 原始值 | 问题 |
|---|---|---|---|---|
| 1 | 001 | A | 80 | 姓名前后有空格 |
| 2 | 002 | A | 90 | 正常 |
| 3 | 003 | B | 70 | 正常 |
| 4 | 004 | B | 空 | 缺失成绩 |
| 5 | 002 | A | 90 | 与第 2 行完全重复 |
| 6 | 005 | B | 120 | 超过 100 |
| 7 | 006 | A | absent | 非数字文本 |
| 8 | 007 | B | 0 | 合法零分,不能误删 |
三、读取时先保护数据语义
|
学号显式按字符串读取,保留前导零。数值列因含 absent 可能成为字符串或其他文本类型,不要直接求均值。默认空值识别规则也可能影响某些文本编码,真实数据应检查 na_values 与 keep_default_na。
常用检查:
|
isna() 识别缺失值,不会把空白字符串、"unknown" 或 120 自动当作错误。先定义数据字典:每列表示什么、单位是什么、允许范围是什么、缺失代表什么。
四、清洗规则要先写出来
本实验采用以下规则:
- 学号、姓名去掉首尾空白,组别统一大写。
- 只自动删除全部字段相同的重复记录。
- 同学号同日期但字段不同视为冲突,停止处理,不能任意保留第一条。
- 成绩转换为数值,非法文本、空值和 0~100 之外的数记为缺失。
- 计算均值时只使用有效成绩,同时报告有效人数。
- 日期无法解析、组别非法或学号缺失时拒绝继续。
将非法值记为缺失只是本实验的选择;正式项目也可输出拒绝表、等待修正,不能把它当所有数据的通用规则。
五、字符串、类型和日期处理
|
coerce 会把不能解析的值变为缺失,不是“修复了数据”。转换后必须检查缺失数量并追踪原因。这里用 .copy() 明确生成独立处理结果,避免链式赋值。
日期 2026-09-01 与 09/01/2026 可能有不同歧义;能规定格式就明确规定。时间戳还应说明时区,而不是只转为 datetime 就结束。
六、缺失值与异常值不能一刀切
| 情况 | 本篇处理 | 其他可能策略 |
|---|---|---|
| 缺失成绩 | 保留记录,均值忽略 | 追查源头、延迟统计 |
| 非法 120 分 | 转缺失并计数 | 拒绝整批、人工核对 |
| 合法零分 | 纳入统计 | 由业务重新确认编码规则 |
| 完全重复 | 删除重复副本 | 若确实是多次事件,应保留 |
| 同键不同值 | 抛错 | 按明确时间与版本规则合并 |
不要直接 dropna() 删除所有含空值的行,也不要无条件 fillna(0)。插补会引入假设;训练机器学习模型时,插补或标准化参数应只从训练集学习,避免数据泄漏。
七、汇总:先看有效样本量,再看平均值
|
清洗后有 7 行,3 条成绩缺失,4 条有效成绩:
| 组别 | 有效成绩 | 有效人数 | 平均分 |
|---|---|---|---|
| A | 80、90 | 2 | 85.0 |
| B | 70、0 | 2 | 35.0 |
count 统计非缺失值,size 统计组内行数。A 组总共有 3 条记录、B 组有 4 条,不等于各组有效成绩人数。小样本差异不能直接推广为整个年级的差异,更不能推出教学方法的因果效果。
八、图表怎样选择?
| 想回答的问题 | 适合的图 | 注意事项 |
|---|---|---|
| 组别均值比较 | 柱状图 | 零基线、显示样本量 |
| 分数分布 | 直方图、箱线图、散点 | 小样本优先展示每个点 |
| 两个变量的关系 | 散点图 | 相关不代表因果 |
| 随时间变化 | 折线图 | 日期先排序,缺测应说明 |
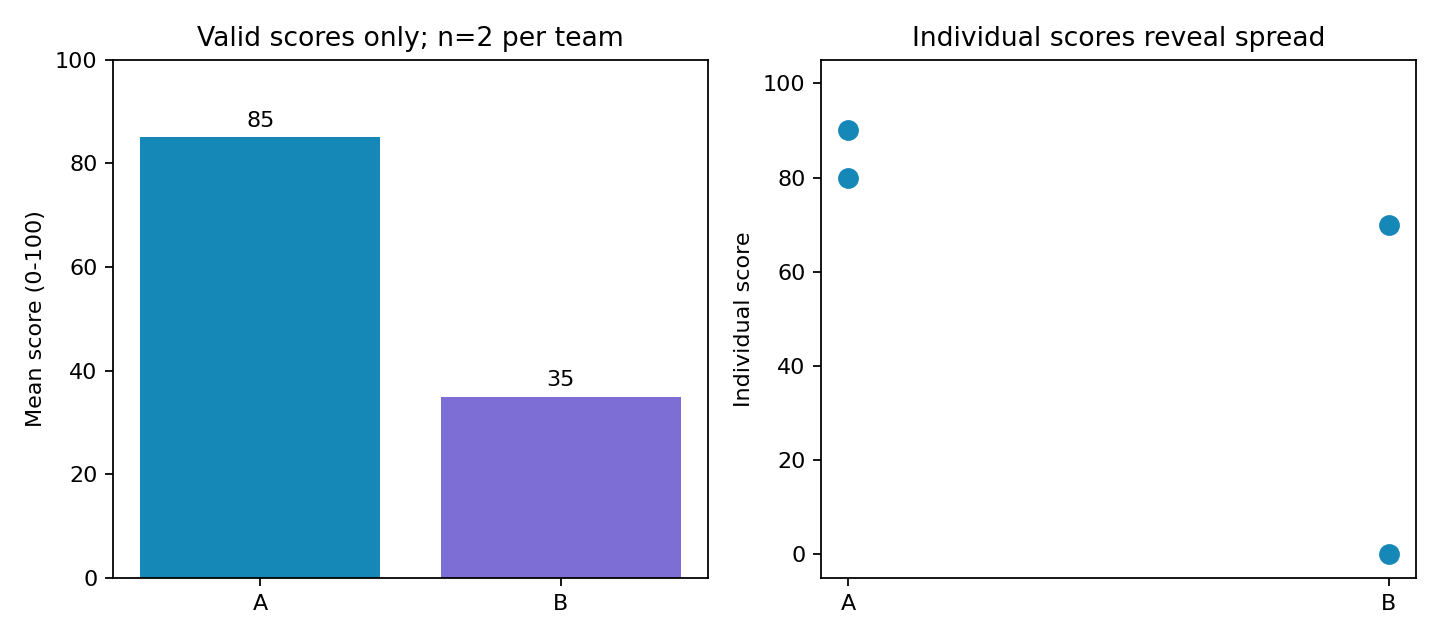
左图统一使用 0~100 纵轴,避免截断轴夸大差异;右图显示个体数据,防止一个均值掩盖组内差异。图片由配套脚本实际生成,标题中的 n=2 是有效人数,不是原始行数。
|
保存图片时说明单位、口径、样本量和数据来源。不要用 3D 装饰、面积不成比例的图形或不一致坐标轴制造差异。
九、保存产物与审计
完整脚本会生成:
|
同时输出:
|
脚本中的数量与均值断言专门核对本篇 8 行教学样例;更换数据时,应保留通用合法性校验,并按自己的数据重新定义这些预期,不能直接删除检查后声称验证通过。
原始 CSV 不覆盖,代码记录规则。CSV 不保存 dtype、时区或数据库约束,重新读取时仍应指定学号类型;index=False 避免把 DataFrame 索引当普通列写出。
十、连接、合并和常见陷阱
将成绩与学生信息合并时,可验证键关系:
|
这是接口示例,scores 与 students 需由自己的数据准备。键重复会让连接结果膨胀,因此应核对行数变化。两个文件都要把学号读成字符串;字符串 "001" 与整数 1 不应靠猜测自动等同。
十一、练习与参考答案
- 把缺失值填 0 再算均值,与正文比较。答案:A 为约 56.67,B 为 17.5;这改变了统计含义,不是等价处理。
- 加入学号 001、同一天、成绩 82 的新行。脚本应报告冲突,而不是静默去重。
- 加入非法日期,确认代码拒绝继续。
- 在图中标注总人数和有效人数,避免 n 的口径不清楚。
- 小项目:用自己的非敏感数据完成数据字典、清洗日志、至少两种图及一段有边界的结论。
完成标准: 原始数据可追溯,8→7→4 的数量变化能解释,零分没有被删除,图表与表格结果一致,换目录也可通过明确参数运行。
十二、学习资料
- pandas 官方入门:读写、选择、分组和绘图。
- pandas 缺失数据指南:区分缺失标记与处理策略。
- Matplotlib 官方 Quick start:Figure、Axes 与导出。
- scikit-learn 常见陷阱:进一步理解数据泄漏。