Python 专区
Python pandas
表格读取、索引、缺失值、分组与连接,配合真实输出练习。
展开本篇目录
一、为什么学习 pandas?
pandas 用带标签的 Series 和 DataFrame 处理表格数据,适合 CSV、统计、清洗、分组和连接。NumPy 侧重数组,pandas 更关注列名、索引、缺失值与表格关系。
先修 Python 和简单数组知识。路线:读取 → 检查结构 → 选择 → 清洗 → 分组 → 连接 → 导出。掌握这些以后,再做数据清洗与可视化实践。
|
二、Series、DataFrame、index 与 columns
|
index 是行标签,不一定是连续整数,也不自动等于业务主键。排序和筛选后索引可能保留原值;是否重置索引取决于用途,不是“索引不连续就一定错误”。
三、读取、检查与保存
|
此代码需要自己的 students.csv。本篇完整脚本内置虚构数据,不用先准备文件。CSV 不保存完整 dtype,读回学号时应指定字符串,否则前导零可能丢失;Excel 读写可能需要额外引擎包,例如 openpyxl,不能因为装了 pandas 就认为所有格式均可用。
四、loc、iloc 与条件筛选
|
.loc[10:20] 标签切片通常包含终点,而 .iloc[0:2] 位置切片不包含终点。不要把两种规则混用。组合条件使用括号和 &、|,不要用 and/or。
修改应使用一次明确的 loc:
|
不要依赖 frame[mask]["score"] = ... 这种链式赋值。不同 pandas 版本对复制与视图的处理有演进,一次定位并赋值更清楚。
五、字符串、日期与数值类型
|
coerce 会把不能解析的值转成缺失,不是已经修复了原始问题。转换前后都应记录异常数量。对字符串列,.str 接口比逐行手写循环更贴近表格操作。
六、缺失值、零分与布尔列
|
这里刻意保留“未知是否及格”与“不及格”的区别。isna() 检查缺失;fillna(0) 会改变含义,不能无条件使用。需要可空整数时可了解 Int64,它与 NumPy 的 int64 命名和空值能力不同。
七、排序、去重与聚合
|
去重前先定义“一条记录”的身份。按学号去重可能误删多门课程或多次测量;同键不同值不应静默保留第一条。
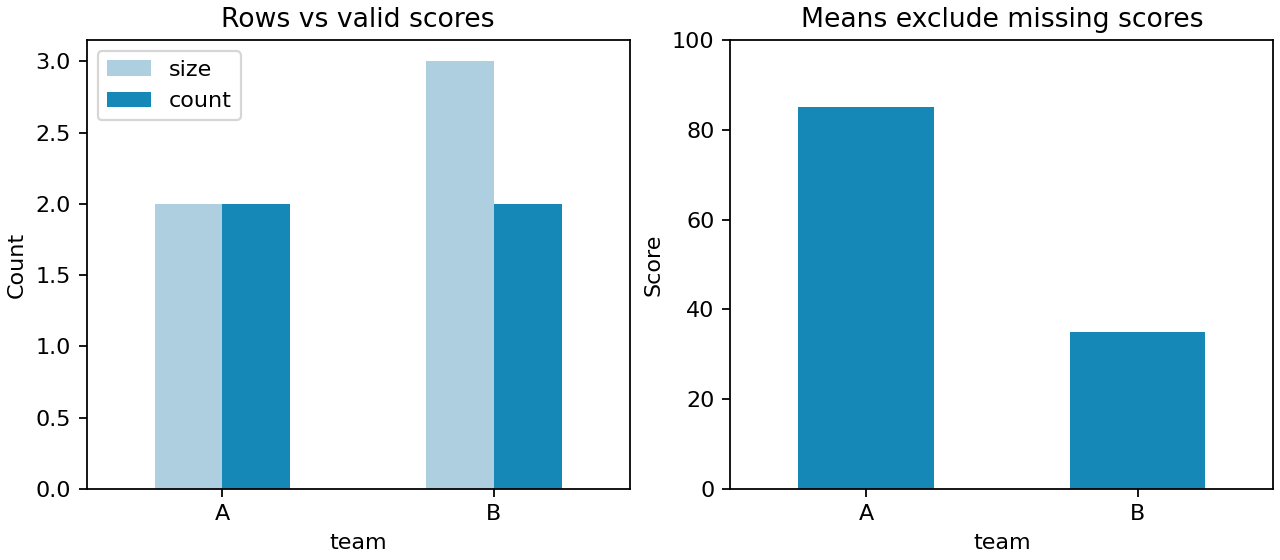
完整实验使用如下虚构数据:A 组 80、90;B 组 70、缺失、0。分组统计:
|
这段需要具有 team 列的完整样例表;size 包括缺失所在行,count 只数有效分,mean 忽略缺失。
| 组别 | size | count | mean |
|---|---|---|---|
| A | 2 | 2 | 85.0 |
| B | 3 | 2 | 35.0 |
B 组的零分参与均值,缺失不参与。不能把图中的“2 个有效成绩”解释成“B 组只有 2 人”。
八、merge 与 concat:连接不是堆叠
|
merge 按键关联列,concat 按指定轴拼接对象。右表 team 重复会放大左表行数;validate 明确关系并拒绝不符合预期的输入。
|
这会得到重复内容,不会自动做业务去重。pandas 的 merge 对空键的匹配行为与通常 SQL NULL 连接语义不同,含缺失键时应先显式处理并核对结果。
九、透视与长宽表
|
pivot 要求每个行列组合唯一;有重复组合时会报错。pivot_table 可以聚合,但要明确 aggfunc,不能让默认求均值掩盖数据冲突。melt 用于把宽表拆回长表。
十、性能与可复现
优先使用列运算、聚合和字符串接口,避免对每行 apply 一个本可向量化的简单函数。但性能判断应测量,不能认为任何 apply 都错误。大文件可以按列读取或 chunksize 分块;若要计算全局去重、排序或分组,跨块状态需要额外设计。
保留原始数据、清洗规则、行数变化和输出文件。不要在清洗过程中覆盖唯一输入,也不要把 DataFrame 的屏幕预览当成完整数据检查。
十一、完整实验、练习与排错
|
生成 students.csv、summary.csv 和本文图表,断言学号前导零、有效人数、均值以及连接行数。脚本的预期值针对内置教学数据。
- 比较
frame["score"]与frame[["score"]]的 shape。 - 增加一条缺失成绩,预测 size/count/mean 的变化。
- 在导师表加入第二条 A 记录,观察 validate 的异常。
- 用 loc 筛出 B 组的有效成绩,确认零分没有被错误过滤。
- 小项目:把一份长表变成透视表,写清楚重复键规则,并完成导出再读回的类型核对。
遇到结果不对时,依次检查列名、dtype、缺失、重复键与连接前后行数,比直接删除报错语句更有效。